한 줄 요약: Ollama는 로컬에서 LLM을 실행할 수 있는 오픈소스 도구다. macOS/Linux/Windows에서 한 줄 명령으로 Llama 3, Mistral, Gemma 등을 실행하고, REST API로 앱에 통합할 수 있다. Ollama는 로컬 머신에서 대형 언어 모델(LLM)을 실행하기 위한 오픈소스 런타임이다. Docker가 컨테이너를 추상화하듯, Ollama는 모델 다운로드·실행·관리·API 서빙을 단일 CLI로 추상화한다.
Ollama는 로컬 머신에서 대형 언어 모델(LLM)을 실행하기 위한 오픈소스 런타임이다. Docker가 컨테이너를 추상화하듯, Ollama는 모델 다운로드·실행·관리·API 서빙을 단일 CLI로 추상화한다.
2023년 출시 이후 GitHub 스타 10만 개를 넘기며 로컬 AI 실행 도구의 사실상 표준이 됐다. 2026년 현재 Llama 3.3, Gemma 2, Mistral, DeepSeek V3, Phi-4 등 100개 이상의 모델을 지원한다.
로컬 LLM을 선택하는 이유 세 가지
프라이버시: 입력 데이터가 외부 서버로 전송되지 않는다. 코드, 내부 문서, 고객 데이터를 모두 로컬에서 처리할 수 있다. 금융·의료·법무 도메인처럼 데이터 외부 전송이 제한된 환경에서 특히 중요하다.
비용: OpenAI API 호출 비용이 없다. 모델을 한 번 다운로드하면 추가 요금 없이 무한 호출할 수 있다. 대량 배치 작업, 개발·테스트 환경, 내부 툴링에 유리하다.
오프라인 실행: 인터넷 연결 없이 동작한다. 비행기, 내부망 환경, 폐쇄망 서버에서도 LLM 기반 기능을 제공할 수 있다.
Ollama는 단순 추론 실행기가 아니라 모델 레지스트리(ollama.com/library), Modelfile 기반 커스텀 모델 빌드, OpenAI 호환 REST API까지 제공하는 로컬 LLM 플랫폼이다.
Ollama로 로컬 LLM 실행하기 — 설치부터 API 서버까지 — 프로젝트 구조 다이어그램 (출처: 공식 문서 및 벤치마크 데이터 기반)
설치 방법 — OS별 가이드
Ollama는 macOS, Linux, Windows 세 플랫폼을 지원한다. 각 플랫폼에서 설치 후 ollama serve가 백그라운드 데몬으로 실행되며, localhost:11434에서 API를 수신한다.
macOS
Homebrew를 사용하는 것이 가장 간편하다. brew install ollama 한 줄로 설치가 완료된다. Apple Silicon(M1/M2/M3/M4) Mac은 Metal GPU 가속을 자동으로 활용하며, 통합 메모리 구조 덕분에 Intel Mac 대비 추론 속도가 3~5배 빠르다. macOS 앱으로 설치할 경우 ollama.com에서 .dmg 파일을 내려받아 실행하면 메뉴바 아이콘으로 상주한다.
Linux
공식 설치 스크립트를 curl로 실행하는 방법이 권장된다. NVIDIA GPU가 있는 경우 CUDA 드라이버(버전 12.x 이상)가 사전 설치돼 있어야 GPU 가속이 활성화된다. AMD GPU는 ROCm을 통해 지원한다. GPU가 없는 CPU-only 환경에서도 동작하지만, 7B 모델 기준 토큰 생성 속도가 GPU 대비 현저히 느리다(약 5~15 tokens/s vs. 30~60 tokens/s).
Windows
ollama.com/download에서 Windows 인스톨러(.exe)를 내려받아 실행한다. NVIDIA GPU가 있으면 CUDA 가속이 자동 감지된다. WSL2 환경에서도 Linux 설치 방법과 동일하게 사용할 수 있다.
macOS에서 Ollama 설치
brew install ollama
ollama serve
Linux에서 Ollama 설치
curl -fsSL https://ollama.com/install.sh | sh
ollama serve
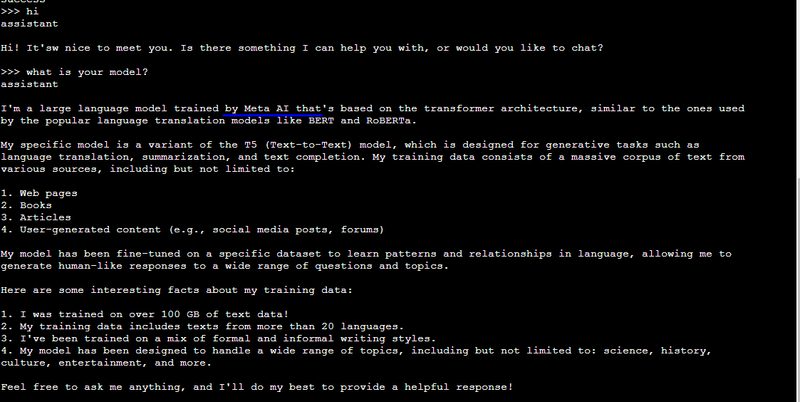
ollama run llama3 명령으로 로컬에서 LLM과 대화하는 모습.
주요 모델 비교
Ollama 라이브러리에서 제공하는 주요 모델의 사양과 용도를 정리했다. VRAM 요구량은 기본 컨텍스트 길이(4096 토큰) 기준이며, num_ctx를 높이면 VRAM 사용량이 늘어난다.
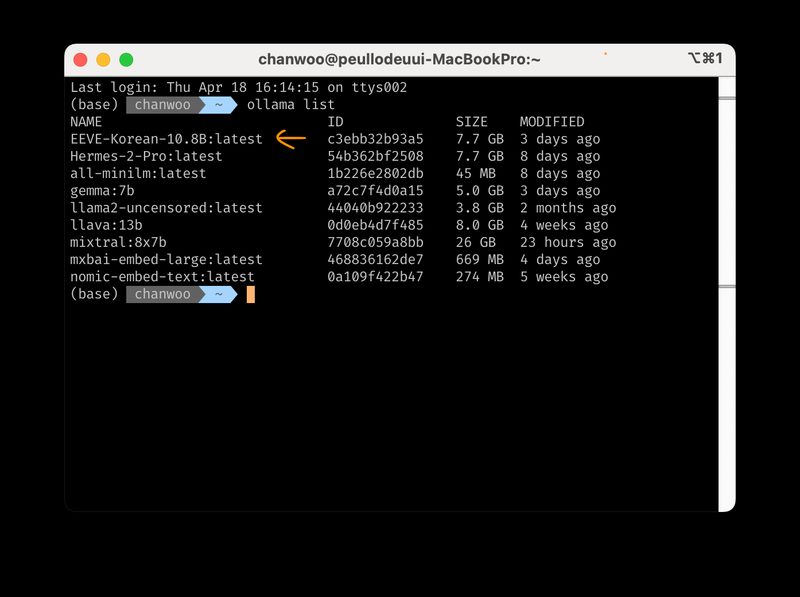
Ollama의 기본 명령은 세 가지다. ollama pull로 모델을 다운로드하고, ollama run으로 대화형 셸을 실행하며, ollama list로 설치된 모델을 확인한다.
기본 명령어
ollama pull llama3.3: 모델 다운로드 (run 시 자동 실행됨)
ollama run llama3.3: 대화형 프롬프트 시작
ollama run mistral "코드 리뷰해줘": 단일 프롬프트 실행 후 종료
ollama list: 설치된 모델 목록과 크기 확인
ollama rm llama3.3: 모델 삭제
ollama ps: 현재 메모리에 로드된 모델 확인
Modelfile로 커스텀 모델 생성
Modelfile은 베이스 모델 위에 시스템 프롬프트, 파라미터, 어댑터를 지정하는 설정 파일이다. Docker의 Dockerfile과 유사한 개념이다. 아래는 한국어 백엔드 어시스턴트를 만드는 예시다.
Modelfile로 커스텀 모델 생성
FROM llama3.3
SYSTEM "You are a senior backend engineer. Answer in Korean."
PARAMETER temperature 0.7
PARAMETER num_ctx 8192
커스텀 모델 빌드 및 실행
ollama create my-assistant -f Modelfile
ollama run my-assistant
Ollama의 REST API로 자체 앱에 LLM을 통합하는 구조.
REST API로 앱에 통합하기
Ollama는 ollama serve 실행 시 localhost:11434에서 REST API를 제공한다. 두 가지 주요 엔드포인트를 사용한다.
/api/generate
단일 프롬프트에 대한 응답을 생성한다. stream: true(기본값)로 설정하면 NDJSON 형식으로 토큰을 스트리밍한다. stream: false는 전체 응답이 완성된 후 반환한다.
/api/chat
OpenAI Chat Completions API와 동일한 messages 배열 형식을 받는다. role: "system", role: "user", role: "assistant"로 대화 히스토리를 관리한다. OpenAI SDK를 사용하는 기존 코드에서 baseURL만 변경하면 Ollama로 교체할 수 있다.
OpenAI 호환 엔드포인트
Ollama는 /v1/chat/completions 형식도 지원한다. OpenAI Python SDK 또는 JavaScript SDK에서 base_url="http://localhost:11434/v1", api_key="ollama"로 설정하면 기존 OpenAI API 코드를 그대로 재사용할 수 있다.
스트리밍 처리 시 주의사항:stream: true일 때 응답은 \n 구분자로 나뉜 JSON 객체 스트림이다. Node.js에서는 response.body를 TextDecoder와 ReadableStream으로 처리하고, Python에서는 requests의 iter_lines()를 사용한다.
원인: CUDA/ROCm 드라이버 미설치 또는 버전 불일치. ollama run llama3.3 실행 후 ollama ps 결과에서 Size 옆에 GPU가 표시되지 않으면 CPU 모드다. 해결: NVIDIA는 CUDA 12.x 드라이버를 설치하고 nvidia-smi로 확인한다. AMD는 ROCm 6.x를 설치한다. macOS는 별도 설정 없이 Metal이 자동 사용된다.
케이스 2: 모델 로드 중 메모리 부족 오류
원인: 모델 크기가 사용 가능한 VRAM을 초과한다. error: model requires more system memory 메시지가 나타난다. 해결: 더 작은 모델로 교체하거나, Modelfile에서 PARAMETER num_ctx 2048로 컨텍스트 크기를 줄인다. 또는 quantization 수준이 낮은 변형(Q4 대신 Q2)을 사용한다. OLLAMA_NUM_GPU=0 환경변수로 강제 CPU 실행도 가능하다.
케이스 3: 추론 속도가 너무 느리다
원인: CPU 모드로 실행 중이거나, 컨텍스트 길이가 너무 길다. 해결: GPU 감지 여부를 먼저 확인한다. GPU 모드임에도 느리면 num_ctx를 줄이거나 더 작은 모델을 사용한다. 여러 모델이 동시에 로드된 경우 ollama stop <모델명>으로 미사용 모델을 언로드한다.
케이스 4: 포트 충돌 — 11434 포트가 이미 사용 중
원인: 다른 프로세스가 11434 포트를 점유 중이거나, Ollama가 이미 실행 중이다. 해결: OLLAMA_HOST=0.0.0.0:11435 환경변수로 포트를 변경하거나, lsof -i :11434(macOS/Linux)로 점유 프로세스를 확인해 종료한다.
VRAM 부족 시: 70B 모델은 최소 40GB VRAM이 필요하다. 8GB GPU라면 7B~9B 모델을 사용하거나, num_ctx를 2048로 줄여라. M1/M2/M3 Mac은 통합 메모리를 활용하므로 16GB 이상이면 13B까지 원활하다.